版本1017
思考不必等待 闪光已经抵达
DeepSeek 4.1 Flash 1017 是为交互而生的推理模型:首字 0.14 秒,每秒 340 个 token,上下文 100 万。按下回车时,答案已经在回来的路上。
深海
闪光
0.14
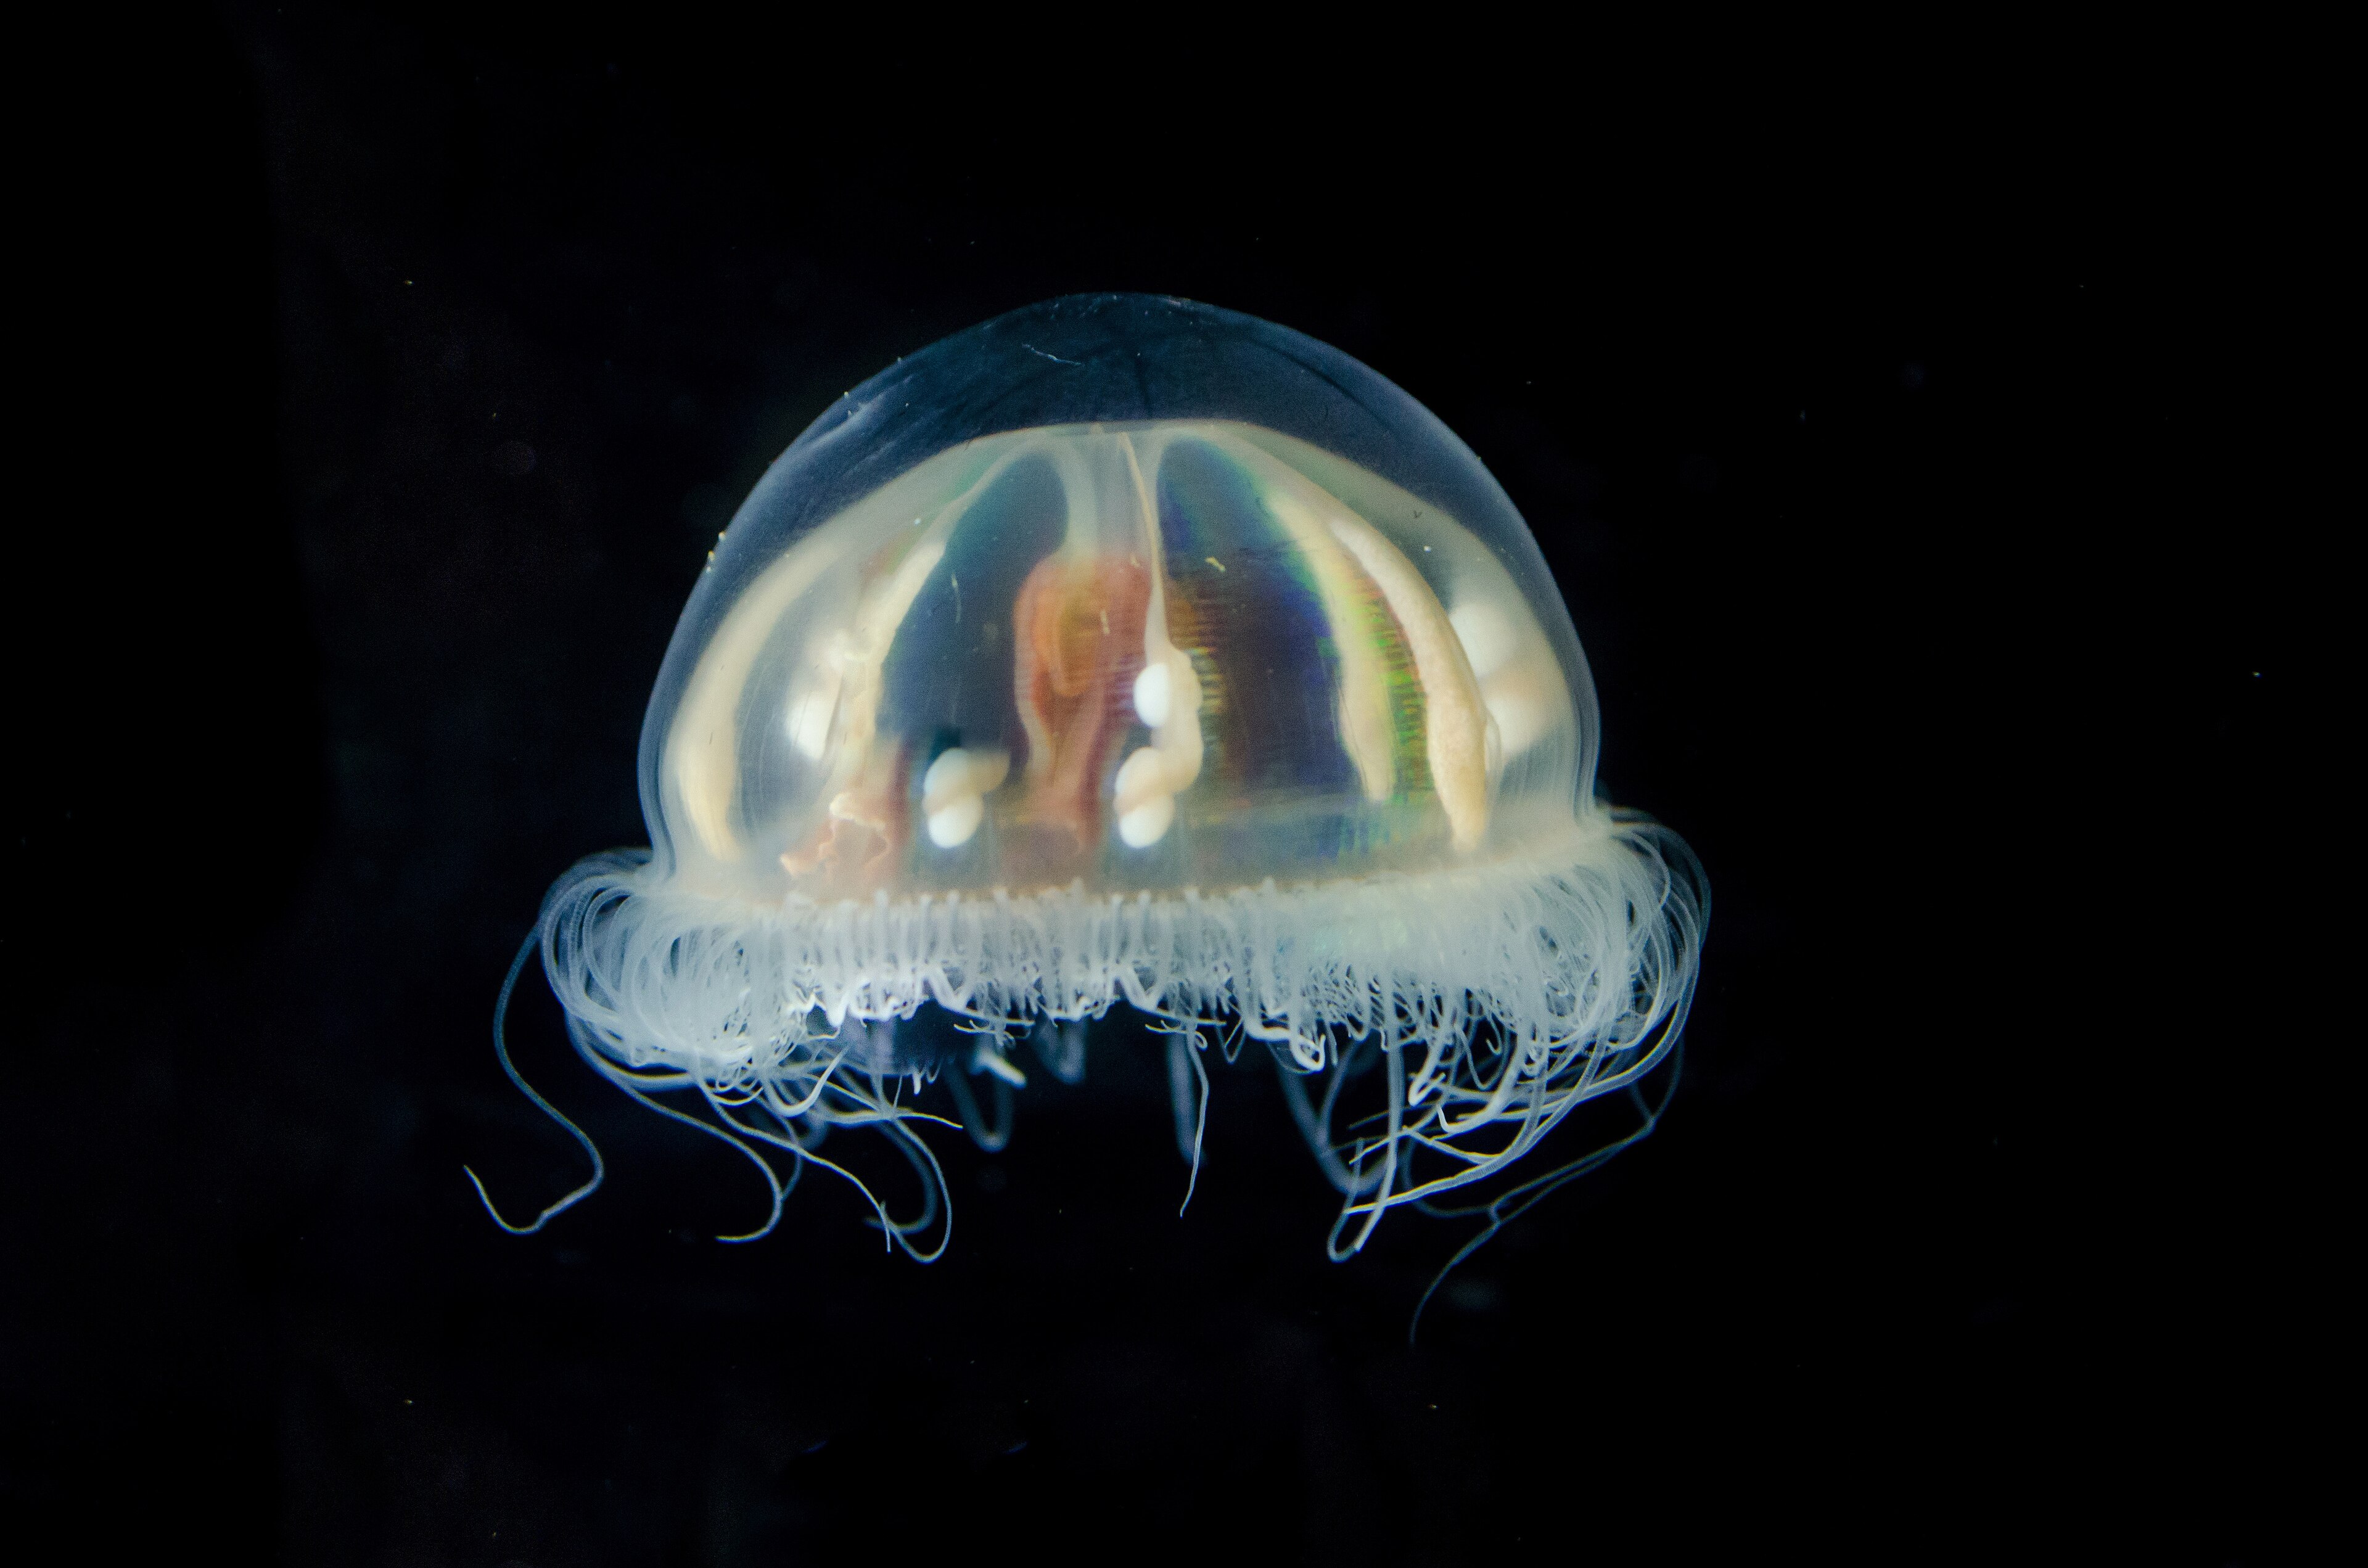
DeepSeek 的名字来自深海:在没有光的地方,探测器用一次闪光看清周围。Flash 也是这样,不把时间花在等待上。我们把它做成一束光:0.14 秒亮起,每秒 340 个 token 铺开,100 万上下文一直照到最深处。它不制造更长的回答,只让回答更早抵达。接进对话框、编辑器、客服或智能体,慢就不再是一个需要解释的问题。
每天,你省下多少等待?
23.1
小时
按每次请求少等 1.66 秒计算(首字 1.80 秒 → 0.14 秒),取你的每日调用量。并发请求不排队。
这些是每天被交给 4.1 Flash 的事:把问题拆开、把代码写完、把一百万字读完,再给一个能用的答案。
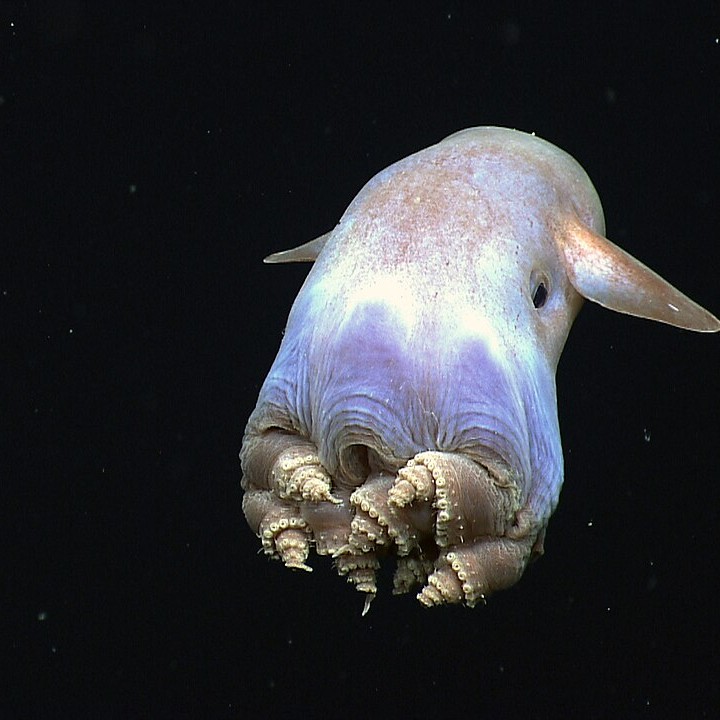
这里的灯,是生物自己点的。
一次请求
深海里的生物,为什么要发光?
已思考 1,204 tokens:先确认发光的两种用途,再对应到产品名。
from deepseek import DeepSeek

client = DeepSeek(api_key=os.environ["DS_KEY"])
res = client.chat(
    model="deepseek-4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    stream=True,
)
for chunk in res:
print(chunk.delta, end="")示例数据。改动右侧参数,这张卡片会立刻重写。
它先想,再回答。
换一个场景,回答的写法也跟着换:推理给判断,代码给能跑的函数,长文给结构,多语言切到对应的语言。
上下文可以很长。
从 8K 到 1M,首字延迟几乎不变。整份财报、整个代码仓库放进去,答案仍在同一秒开始。
第一个字先到。
流式输出把等待切成很多小段,你可以边读边等。关掉流式,你会拿到完整的一段,多花 0.4 秒。
想多深,由你定。
快答直接给结论,深思把过程也交出来。两种都在同一个接口里,改一个参数就能换。
常见问题
0.14 秒是怎么测出来的?
流式输出下,从请求发出到第一个 token 抵达的中位耗时。输入 32k tokens,华东节点,2026 年 10 月实测。数字会随网络和负载浮动,量级不会变。
100 万上下文是什么概念?
约 150 万汉字,或 7 万行代码,或 16 份两百页的年报正文。首字延迟基本不随长度变化,长文不会把等待拖长。
和 4.1 Pro 怎么选?
同一代基座。Flash 用更小的激活参数和投机解码换延迟,适合交互、客服与批处理;Pro 留给需要长链推理和更重验证的任务。
会开放权重吗?
会。2026 年第一季度起以 MIT 许可开放权重,包含 4.1 Flash 本体和面向小设备的蒸馏版本。仓库、模型卡和评测脚本会一起放出来。
怎么接入?
兼容 OpenAI 接口:把 base_url 换成 api.deepseek.com,model 填 deepseek-4.1-flash,原有 SDK 和调用代码不用改。流式、函数调用、JSON 输出都支持。
请求会被用来训练吗?
不会。API 数据不进入训练;日志保留 7 天用于排查故障,到期自动删除。企业版可以把日志留在自己的区域。
每周开放 500 个名额,附 200 万 token 试用额度。提交后会打开发往 4.1flash@deepseek.com 的邮件,附上你的地址。